
kafka梳理
关键点
- 概念的解析
- kafka的架构图
- 架构深入
- kafka的工作流程及文件存储机制
- kafka的生产者:a.分区策略 b.数据可靠性保证 c.数据一致性保证
- kafka的消费者:a.消费方式 b.分区分配策略 c.offset的维护
- zookeeper的作用
- Kafka常见面试题:根据问题去了解大概
Kafka的几个概念
此处可以结合本系列上篇文章kafka大白话入门,对Kafka先有个感性认识,再来理解几个概念。
此处简单的前情提要:
假设本身有A和B要通信,他俩直接聊就行了,这时候比如就形成一条通信链路;
如果左右各有3人要通信呢,那就会变成3*3=9条通信链路,
当多对多的情况下就会进而演变为N*N条通信线路,极度复杂冗余,所以抽出来一层,用来接收和转发,这个就是消息队列(kafka)。
Notice:
- 同一个消费者组里的消费者不能消费同一个分区。但可以同时消费同一个主题topic
- 隐藏概念:
- acks应答机制
- ISR(in-sync replica set 待同步复制集合):ack分区的副本leader和follower
- Exactly Once语义
概念
- 1 )Producer :消息生产者,就是向 kafka broker 发消息的客户端;
- 2 )Consumer :消息消费者,向 kafka broker 取消息的客户端;
- 3 )Consumer Group (CG ):消费者组,由多个 consumer 组成。 消费者组内每个消费者负
- 责消费不同分区的数据,一个分区只能由一个 组内 消费者消费;消费者组之间互不影响。所有的消费者都属于某个消费者组,即 消费者组是逻辑上的一个订阅者。
- 4 )Broker :一台 kafka 服务器就是一个 broker。一个集群由多个 broker 组成。一个 broker可以容纳多个 topic。
- 5 )Topic :可以理解为一个队列, 生产者和消费者面向的都是一个 topic;
- 6 )Partition :为了实现扩展性,一个非常大的 topic 可以分布到多个 broker(即服务器)上,一个 topic 可以分为多个 partition,每个 partition 是一个有序的队列;
- 7 ) Replica :副本,为保证集群中的某个节点发生故障时,该节点上的 partition 数据不丢失,且 kafka 仍然能够继续工作,kafka 提供了副本机制,一个 topic 的每个分区都有若干个副本,一个 leader 和若干个 follower。
- 8 )leader :每个分区多个副本的“主”,生产者发送数据的对象,以及消费者消费数据的对象都是 leader。
- 9 )follower :每个分区多个副本中的“从”,实时从 leader 中同步数据,保持和 leader 数据的同步。leader 发生故障时,某个 follower 会成为新的 follower。
补充
- Broker:消息中间件处理结点,一个Kafka节点就是一个broker,多个broker可以组成一个Kafka集群;
- Topic:一类消息,例如page view日志、click日志等都可以以topic的形式存在,Kafka集群能够同时负责多个topic的分发;
- Partition:topic物理上的分组,一个topic可以分为多个partition,每个partition是一个有序的队;
- Segment:每个partition又由多个segment file组成;
- offset:每个partition都由一系列有序的、不可变的消息组成,这些消息被连续的追加到partition中。partition中的每个消息都有一个连续的序列号叫做offset,用于partition唯一标识一条消息;
- message:这个算是kafka文件中最小的存储单位,即是 a commit log。
Kafka架构图
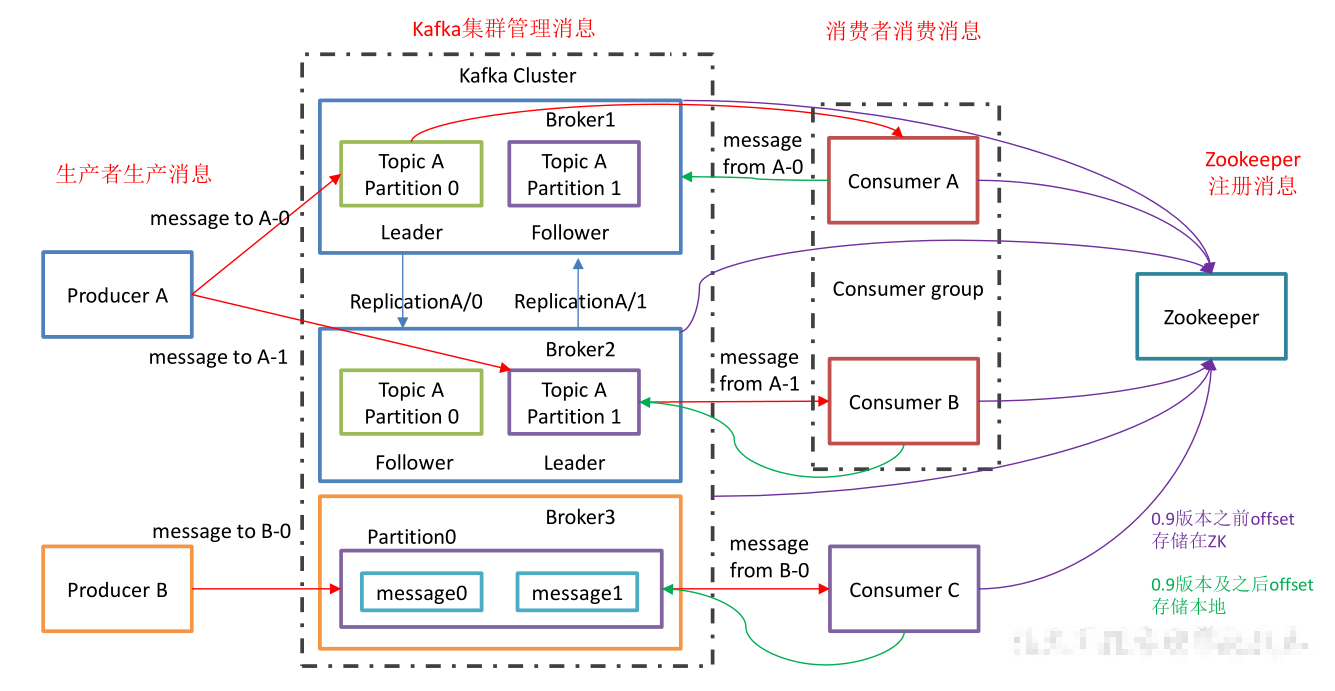
总结:
-
消息是分主题的,然后为了扩展性,每个主题又有许多分区(分片和索引机制),这些分片可以跨机存在
-
每个分区内部又是有序的队列,索引从0.1.2..开始这种的
-
注意副本的概念:副本是针对分区的,每个分区都有若干副本(一leader和多follower)
-
副本的leader和follower又有崩溃后选主的策略,然后对应一些ISR的概念
Kafka工作流程及文件存储机制
工作流程
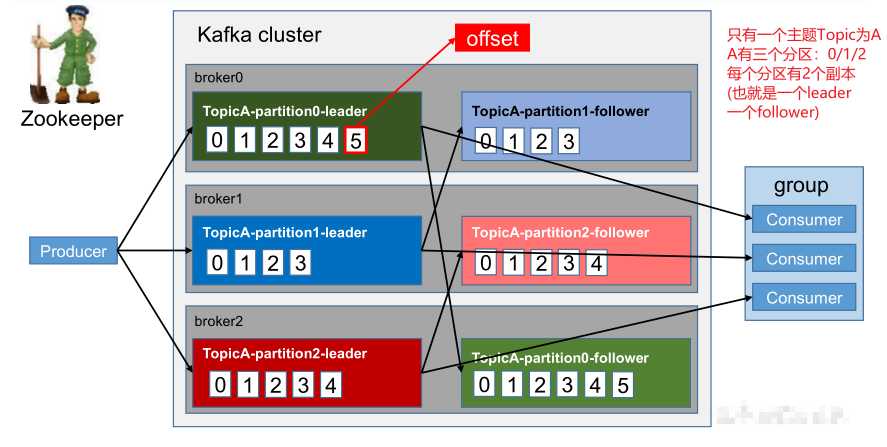
简单描述下:
-
上图中Kafka集群中有3个broker,每个broker放了两个分区;
-
整体只有一个主题Topic为A;A有三个分区:0/1/2;
-
每个分区有2个副本(也就是一个leader一个follower);
Kafka中的消息是以topic来分类的,生产者和消费者都是面向topic的,不过topic是个逻辑上的概念,而partition是物理上的概念,所以存盘的最小粒度单位是分区。
每个partition都对应于一个log文件,log保存的就是生产者生产的数据,生产者的消息会不断追加到log文件,且每个消息都会有自己的offset。
每个partition中的消息是以log的形式存在,但是Kafka的消息最底层用的是LogSegment(日志段),因为单个log文件大小上限为1G,超过后会生成新的log文件。也就是说一个partition可能对应多个log文件。
Kafka的一个日志段包括一个消息日志文件和若干索引文件组成,即一个.log和.index文件
存储机制
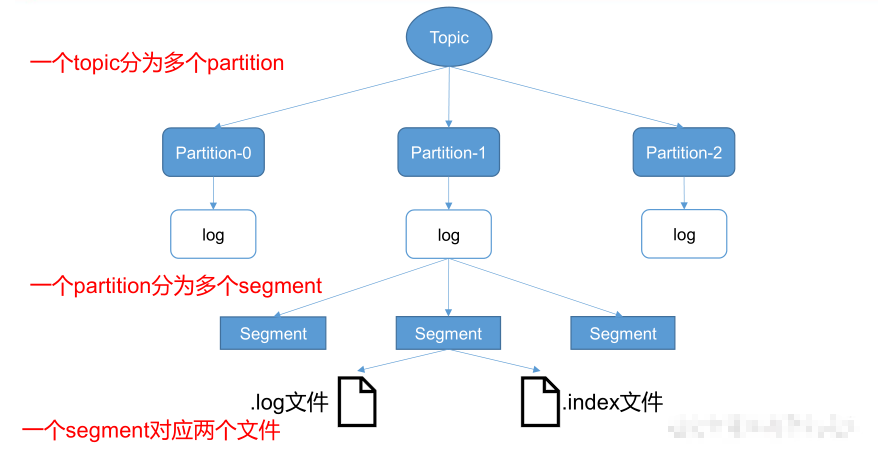
由于生产者生产的消息会不断追加到 log 文件末尾,为防止 log 文件过大导致数据定位效率低下,Kafka 采取了 分片和 索引机制,将每个 partition 分为多个 segment。每个 segment对应两个文件 ——“.index”文件和“.log”文件。这些文件位于一个文件夹下,该文件夹的命名规则为:topic 名称+分区序号。例如,first 这个 topic 有三个分区,则其对应的文件夹为 first-0,first-1,first-2。
00000000000000000000.index
00000000000000000000.log
00000000000000170410.index
00000000000000170410.log
00000000000000239430.index
00000000000000239430.log
kafka把数据存在磁盘中,怎样保证较快的读取呢?
-
partition是以文件夹的形式存储在具体Broker本机上
-
数据保存为log,log有分片和索引机制,分为很多segment,
-
保存形式为:000.index--000.log,然后超过1g以后生成新的segment。
-
那么新的segment怎么命名呢?命名为本segment中最小的消息id,这样在查数据的时候就可以利用二分了。
-
xx.index文件存offset--(对应log中的起始位置和大小),比如xx.index中存【3--(756,1000)】,那么就会去xx.log中读取756-1756这段的数据。
-
因此,虽然kafka是磁盘存储,但是读写速度还是很快的。
-
磁盘的顺序读写比乱序内存读要快吗?
-
index 和 log 文件以当前 segment 的第一条消息的 offset 命名。
index文件和log文件详解:
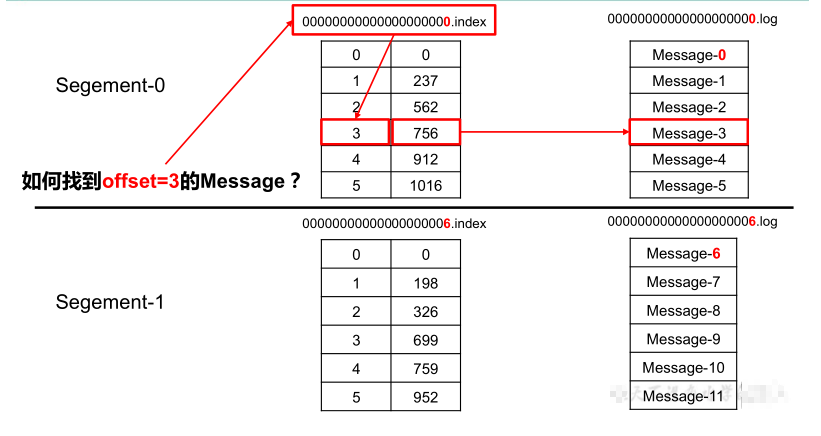
".index"文件存储大量的索引信息,".log"文件存储大量的数据,索引文件中的元数据指向对应数据文件中 message 的物理偏移地址。

因为索引的存在,所以查数据的时候使用了二分,故读写速度比较快。
总结
- Broker:消息中间件处理结点,一个Kafka节点就是一个broker,多个broker可以组成一个Kafka集群;
- Topic:一类消息,例如page view日志、click日志等都可以以topic的形式存在,Kafka集群能够同时负责多个topic的分发;
- Partition:topic物理上的分组,一个topic可以分为多个partition,每个partition是一个有序的队;
- Segment:每个partition又由多个segment file组成;
- offset:每个partition都由一系列有序的、不可变的消息组成,这些消息被连续的追加到partition中。partition中的每个消息都有一个连续的序列号叫做offset,用于partition唯一标识一条消息;
- message:这个算是kafka文件中最小的存储单位,即是 a commit log。
kafka的message是以topic为基本单位,不同topic之间是相互独立的。每个topic又可分为几个不同的partition,每个partition存储一部的分message。topic与partition的关系如下:
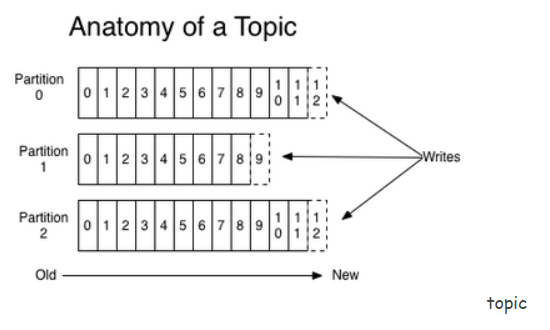
其中,partition是以文件夹的形式存储在具体Broker本机上。
参考:Kafka之数据存储