
Python -- 网络编程 -- 抓取网页图片 -- 图虫网
时间:2014-05-10 01:30:27
收藏:0
阅读:610
字符串(str)编码成字节码(bytes),字节码解码为字符串
获取当前环境编码:sys.stdin.encoding
url编码urllib.parse.quote()
url解码urllib.parse.unquote()
列表去重:pages = list(set(pages))
创建文件夹(可多级创建):os.makedirs(folder) os.mkdir()只能单级创建
首先分析网页(图虫网)的URL规律:
根网页地址形如:
http://tuchong.com/tags/人像/?page=[1, 2, 3 ...]
二级网页链接形如:
href="http://tuchong.com/239137/6400827/"
href="http://hezi1984.tuchong.com/6407909/"
目标图片链接形如:
src="http://photos.tuchong.com/27949/f/6915745.jpg"
-----程序源文件:getPic.py-----

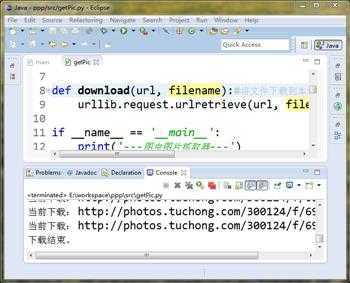
 1 import re, os, time
 2 import urllib.parse
 3 import urllib.request
 4
 5 def getHtml(url):#取得网页的html纯文本
 6     return urllib.request.urlopen(url).read().decode(‘utf-8‘)
 7
 8 def download(url, filename):#将文件下载到本地
 9     urllib.request.urlretrieve(url, filename)
10
11 if __name__ == ‘__main__‘:
12     print(‘---图虫图片抓取器---‘)
13     pageNo = int(input(‘请输入抓取页面的数字后缀(输入q退出):‘))
14     #url汉字编码处理
15     url = ‘http://tuchong.com/tags/{}/?page={}‘.format(16                 urllib.parse.quote(‘人像‘), str(pageNo))
17     #获取页面HTML文本
18     html = getHtml(url)
19
20     #解析HTML文本,得到二级网页的地址(根网页缩略图所指向的链接)
21     rePage = r‘http://tuchong.com/\d+/\d+/|http://\w+(?<!photos).tuchong.com/\d+/‘
22     pages = re.findall(rePage, html)
23     pages = list(set(pages))
24
25     #解析二级网页,下载其中的图片
26     for page in pages:
27         print(‘当前网页:‘, page)
28         html2 = getHtml(page)#取得二级网页内容
29         #解析二级网页中图片地址的正则表达式
30         rePic = r‘http://photos.tuchong.com/.+/f/.+\.jpg‘
31         pics = re.findall(rePic, html2)
32         pics = list(set(pics))
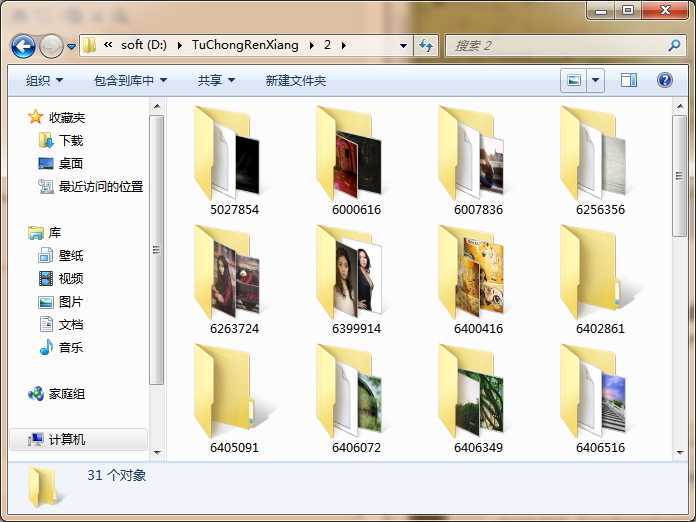
33         folder = ‘D:/TuChongRenXiang/{}/{}‘.format(pageNo, page[-8:-1])
34         if not os.path.exists(folder):
35             os.makedirs(folder)
36             note = open(folder+‘/note.txt‘, ‘wt‘)#在每个文件夹下创建一个日志文件,记录下载地址
37             note.write(‘来源网址:‘+page+‘\n图片原始地址列表:\n‘)
38             for pic in pics:
39                 note.write(pic+‘\n‘)
40             note.close()
41         print(‘目标文件夹:‘, folder)
42         time.sleep(1)#程序暂停一秒
43         for pic in pics:
44             print(‘当前下载:‘, pic)
45             download(pic, folder+‘/‘+pic[-11:])
46     print(‘下载结束。‘)
47
48
49
评论(0)